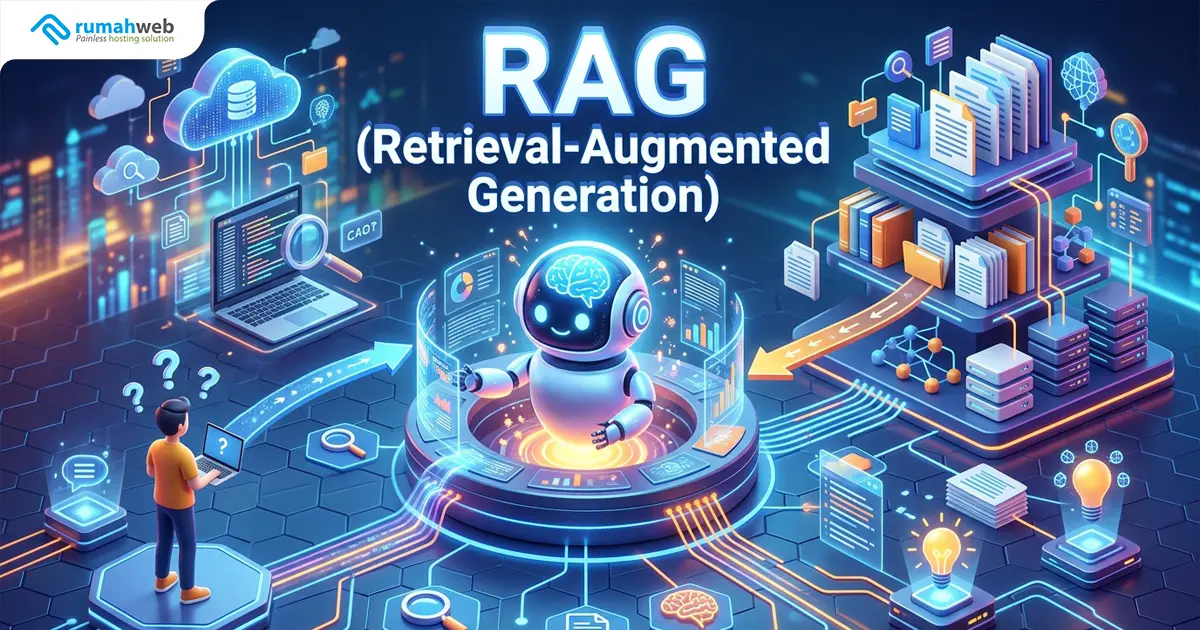
Pernah mendapatkan jawaban dari AI yang terdengar meyakinkan, tetapi ternyata informasinya sudah tidak relevan atau tidak sesuai dengan dokumen yang Anda miliki? RAG adalah pendekatan yang memungkinkan LLM mengambil informasi dari sumber eksternal sebelum menghasilkan jawaban, sehingga respons dapat disesuaikan dengan data yang lebih relevan.
Pendekatan ini semakin penting ketika AI perlu bekerja dengan dokumen internal, knowledge base, atau informasi yang terus berubah. Alih-alih hanya mengandalkan pengetahuan bawaan model, RAG membantu LLM menemukan informasi yang dibutuhkan terlebih dahulu.
Lalu, bagaimana sebenarnya RAG bekerja? Artikel ini membahas konsep dan alur kerja RAG dengan bahasa sederhana, mulai dari chunking, embedding, vector database, retrieval, hingga evaluasi hasilnya.
Also Read
Ringkasan Cepat
- RAG (Retrieval-Augmented Generation) adalah arsitektur yang menggabungkan LLM dengan sistem retrieval (pencarian) ke basis pengetahuan eksternal agar jawaban lebih faktual dan relevan.
- RAG membantu mengurangi halusinasi, mempercepat update pengetahuan (cukup update dokumen), dan memungkinkan jawaban menyertakan sumber.
- Pipeline RAG yang umum ingestion → chunking → embedding → vector database → retrieval → (opsional reranking) → prompt augmentation → generation.
Apa Itu RAG (Retrieval-Augmented Generation)?
RAG (Retrieval-Augmented Generation) adalah metode yang menggabungkan kemampuan LLM dengan proses pencarian informasi dari sumber eksternal. Dengan RAG, model dapat mengambil konteks yang relevan dari dokumen atau database sebelum menghasilkan jawaban.
Jika dianalogikan, RAG adalah ujian dengan konteks open-book. LLM tidak hanya mengandalkan pengetahuan yang sudah dimilikinya, tetapi mendapatkan bahan referensi tambahan saat menjawab.
Kenapa LLM Membutuhkan Retrieval?
LLM tidak otomatis mengetahui informasi terbaru atau data privat milik perusahaan. Tanpa konteks yang tepat, jawaban yang dihasilkan juga bisa tidak sesuai dengan kebutuhan.
Beberapa kondisi yang biasanya membuat RAG dibutuhkan antara lain:
- Informasi yang digunakan sering berubah.
- Perusahaan memiliki dokumen internal seperti SOP, kontrak, pricing, atau katalog.
- Jawaban perlu merujuk pada sumber tertentu agar lebih mudah diperiksa.
- Model perlu menjawab berdasarkan knowledge base khusus.
Dengan retrieval, informasi dari sumber tersebut dapat diberikan sebagai konteks tambahan kepada LLM.
RAG vs Fine-Tuning
RAG dan fine-tuning sama-sama dapat digunakan untuk menyesuaikan kemampuan AI, tetapi tujuannya berbeda.
Secara sederhana:
- Fine-tuning lebih cocok untuk mengubah perilaku, gaya, atau kemampuan model pada tugas tertentu.
- RAG lebih cocok ketika model perlu menggunakan informasi eksternal yang dapat berubah atau berasal dari dokumen khusus.
RAG juga memungkinkan sistem mengambil dokumen terbaru tanpa harus melatih ulang model setiap kali informasi berubah.
Cara Kerja RAG
Secara umum, pipeline RAG terdiri dari beberapa tahap, mulai dari menyiapkan dokumen hingga memberikan konteks kepada LLM.
1. Data Ingestion
Langkah pertama adalah mengumpulkan sumber informasi yang akan digunakan. Sumbernya bisa berupa:
- DOCX
- Dokumentasi teknis
- Notion atau Confluence
- Git repository
- Database
Dokumen kemudian dibersihkan dan dipersiapkan sebelum masuk ke proses indexing.
2. Chunking
Dokumen yang terlalu panjang biasanya dipecah menjadi bagian-bagian kecil atau chunk.
Tujuannya agar sistem lebih mudah menemukan bagian yang benar-benar relevan. Jika chunk terlalu kecil, konteks bisa hilang. Sebaliknya, chunk yang terlalu besar dapat membawa terlalu banyak informasi yang tidak diperlukan.
Karena itu, ukuran chunk perlu disesuaikan dengan jenis dokumen yang digunakan.
3. Embedding
Setiap chunk kemudian diubah menjadi embedding, yaitu representasi numerik yang menggambarkan makna teks.
Dengan embedding, sistem dapat melakukan pencarian berdasarkan kemiripan makna, bukan hanya mencocokkan kata yang sama.
4. Vector Database
Embedding yang sudah dibuat disimpan di vector database. Database ini digunakan untuk melakukan pencarian berdasarkan kemiripan antarvektor.
Beberapa teknologi yang dapat digunakan dalam ekosistem RAG antara lain Pinecone, Weaviate, Milvus, atau database yang mendukung vector search.
5. Retrieval
Ketika pengguna mengirim pertanyaan, pertanyaan tersebut juga diubah menjadi embedding. Sistem kemudian mencari chunk yang paling relevan dari vector database.
Biasanya, sistem mengambil beberapa hasil teratas atau top-k untuk digunakan sebagai konteks.
6. Reranking
Jika hasil pencarian masih terlalu banyak atau kurang tepat, sistem dapat menggunakan reranking untuk mengurutkan kembali hasil retrieval.
Tujuannya adalah memastikan konteks yang diberikan kepada LLM benar-benar relevan dengan pertanyaan pengguna.
7. Generation
Chunk yang sudah dipilih kemudian dimasukkan ke prompt bersama pertanyaan pengguna. LLM menggunakan konteks tersebut untuk menghasilkan jawaban.
Jadi, alurnya secara sederhana adalah:
Dokumen → Chunking → Embedding → Vector DB → Retrieval → Reranking → LLM → Jawaban.
Contoh Arsitektur RAG untuk Bisnis
Untuk aplikasi bisnis, arsitektur RAG biasanya tidak hanya terdiri dari LLM dan vector database. Ada beberapa komponen yang bekerja bersama.
Arsitektur sederhananya dapat terdiri dari:
- Data layer: tempat menyimpan dokumen dan sumber data.
- Indexing layer: menangani proses chunking dan embedding.
- Vector database: menyimpan embedding dan metadata.
- Retrieval layer: mencari informasi yang relevan.
- Backend atau orchestrator: mengatur alur query, retrieval, dan prompt.
- LLM: menghasilkan jawaban.
- User interface: tempat pengguna berinteraksi dengan sistem.
AWS juga menjelaskan bahwa RAG production membutuhkan komponen seperti data processing, embeddings, vector database, retriever, foundation model, guardrails, orchestrator, serta pengelolaan identitas pengguna.
Praktik Terbaik agar RAG Tidak “Ngaco”
RAG tidak otomatis menghasilkan jawaban yang akurat. Kualitas dokumen dan proses retrieval sangat memengaruhi hasil akhirnya.
Beberapa hal yang perlu diperhatikan:
1. Rapikan Dokumen
Dokumen yang digunakan sebaiknya memiliki struktur yang jelas. Pastikan judul, versi, tanggal, dan status dokumen mudah dibedakan.
Misalnya, jangan sampai SOP lama dan SOP terbaru masuk ke knowledge base tanpa informasi versi yang jelas.
2. Sesuaikan Strategi Chunking
Jenis dokumen yang berbeda bisa membutuhkan strategi chunking yang berbeda.
Contohnya:
- SOP: berdasarkan langkah atau subjudul.
- FAQ: berdasarkan satu pertanyaan dan jawabannya.
- Dokumentasi teknis: berdasarkan section atau topik.
- Kontrak: berdasarkan pasal atau bagian dokumen.
3. Gunakan Hybrid Search jika Diperlukan
Vector search bagus untuk mencari berdasarkan makna. Namun, untuk informasi seperti SKU, nomor dokumen, kode produk, atau istilah teknis tertentu, pencarian berbasis keyword juga bisa sangat berguna.
Karena itu, hybrid search dapat digunakan untuk menggabungkan pencarian keyword dan semantic search.
4. Tambahkan Guardrail
Model sebaiknya tidak dipaksa menjawab ketika informasi yang dibutuhkan tidak ditemukan.
Contoh instruksinya:
“Jika informasi tidak ditemukan dalam konteks yang diberikan, katakan bahwa informasi tidak ditemukan dan jangan membuat jawaban berdasarkan asumsi.”
Pendekatan seperti ini membantu membatasi jawaban yang tidak memiliki dasar dari knowledge base.
Risiko Keamanan dan Privasi pada RAG
RAG sering digunakan untuk mengakses dokumen internal perusahaan. Artinya, aspek keamanan tidak boleh dianggap sebagai tambahan belaka.
Beberapa risikonya antara lain:
- Dokumen sensitif dapat muncul kepada pengguna yang tidak memiliki izin.
- Dokumen dapat berisi prompt injection atau instruksi berbahaya.
- Retrieval dapat mengambil informasi dari departemen lain.
- Data pribadi atau informasi rahasia dapat ikut masuk ke konteks LLM.
Karena itu, sistem RAG sebaiknya dilengkapi dengan:
- RBAC (Role-Based Access Control).
- Filter retrieval berdasarkan metadata.
- Klasifikasi dokumen berdasarkan tingkat akses.
- Sanitasi dan validasi dokumen.
- Logging serta audit trail.
Jangan langsung memasukkan seluruh dokumen perusahaan ke satu index tanpa memikirkan hak akses. Dalam sistem RAG, informasi yang bisa ditemukan sistem belum tentu informasi yang boleh dilihat semua pengguna.
Komponen RAG dan Fungsinya
| Komponen | Fungsi | Output |
|---|---|---|
| Chunking | Memecah dokumen | Potongan teks |
| Embedding model | Mengubah teks menjadi vektor | Embedding |
| Vector DB | Menyimpan dan mencari embedding | Kandidat hasil |
| Retriever | Mengambil informasi relevan | Top-k context |
| Reranker | Mengurutkan kembali hasil | Konteks final |
| LLM | Mengolah konteks dan menjawab | Jawaban |
Checklist Membangun RAG
Sebelum langsung memilih vector database, sebaiknya tentukan kebutuhan dan data yang akan digunakan terlebih dahulu.
Gunakan checklist berikut:
- Tentukan use case, misalnya customer service atau internal knowledge base.
- Tentukan sumber data dan siapa pemilik dokumennya.
- Bersihkan dokumen dari duplikasi dan versi yang sudah tidak berlaku.
- Tentukan metadata seperti departemen, tanggal, dan level akses.
- Pilih strategi chunking yang sesuai.
- Pilih embedding model.
- Tentukan vector database.
- Implementasikan retrieval dan reranking jika diperlukan.
- Buat prompt template dan guardrail.
- Uji akurasi, latency, dan coverage.
- Pasang monitoring serta audit log.
VPS sebagai Pendukung Infrastruktur RAG
RAG membutuhkan beberapa komponen seperti API, worker, proses indexing, dan vector database. Jika Anda membutuhkan kontrol lebih besar terhadap lingkungan aplikasi, VPS bisa menjadi salah satu pilihan untuk menjalankan komponen tersebut.
Salah satunya adalah VPS Murah dari Rumahweb, yang menyediakan resource terisolasi, SSD storage, DDoS protection, serta dukungan teknis 24/7. Dengan VPS, Anda dapat mengatur environment sesuai kebutuhan aplikasi RAG yang dikembangkan.
FAQ
RAG (Retrieval-Augmented Generation) adalah arsitektur yang menggabungkan LLM dengan retrieval ke basis pengetahuan eksternal untuk memberi konteks saat menjawab.
Tidak selalu. Fine-tuning berguna untuk gaya/format atau spesialisasi, sementara RAG berguna untuk akses data faktual yang berubah-ubah.
Karena model diberi konteks dokumen yang relevan saat menjawab, sehingga tidak perlu “menebak” dari memori training saja.
Dokumen yang bersih, strategi chunking, embedding yang tepat, retrieval yang bagus (sering dibantu reranking), dan guardrail jawaban.
Kebocoran data dan akses berlebihan. Mitigasinya adalah metadata + RBAC + audit.
Kesimpulan
Retrieval-Augmented Generation (RAG) adalah metode paling praktis untuk memastikan model bahasa besar (LLM) memberikan jawaban berdasarkan data internal yang akurat, spesifik, dan terkini. Walau alur pemrosesannya melibatkan beberapa tahapan teknis, konsep dasarnya bertumpu pada pencarian potongan informasi yang relevan untuk kemudian diterjemahkan oleh AI menjadi penjelasan yang mudah dipahami.
Dengan berfokus pada skenario penggunaan yang jelas, tata kelola dokumen yang terstruktur, serta penerapan kontrol hak akses data yang ketat, RAG dapat menjadi fondasi sistem AI internal yang andal dan memberikan nilai operasional nyata bagi organisasi.