Pernah membayangkan apa yang terjadi ketika server mati, jaringan terputus, atau aplikasi mengalami crash? Di sinilah pentingnya memahami apa itu fault tolerance, yaitu kemampuan sistem untuk tetap beroperasi meskipun satu atau lebih komponennya mengalami kegagalan.
Sistem yang tangguh tidak hanya mengandalkan pencegahan gangguan, tetapi juga mampu meminimalkan dampaknya terhadap layanan. Namun, fault tolerance sering disamakan dengan high availability (HA) dan disaster recovery (DR), padahal ketiganya memiliki fokus berbeda.
Artikel ini membahas tentang apa itu fault tolerance serta perbedaan dengan HA dan DR, lengkap dengan contoh arsitektur serta teknik praktis untuk meningkatkan ketahanan sistem.
Also Read
Ringkasan Cepat
- Fault tolerance adalah kemampuan sistem untuk tetap berjalan ketika satu atau lebih komponen gagal.
- High availability (HA) fokus pada meminimalkan downtime melalui redundansi dan failover, tetapi tidak selalu “zero downtime”.
- Disaster recovery (DR) fokus pada pemulihan setelah kejadian besar (misalnya data center/region down), dengan target RTO/RPO.
Apa Itu Fault Tolerance?
Fault tolerance adalah kemampuan sistem untuk tetap berjalan ketika satu atau lebih komponennya mengalami kegagalan. Dengan kata lain, ketika salah satu bagian sistem bermasalah, layanan tidak langsung ikut berhenti. NIST juga mendefinisikan fault tolerance sebagai kemampuan sistem untuk tetap beroperasi dengan benar meskipun terdapat komponen yang gagal.
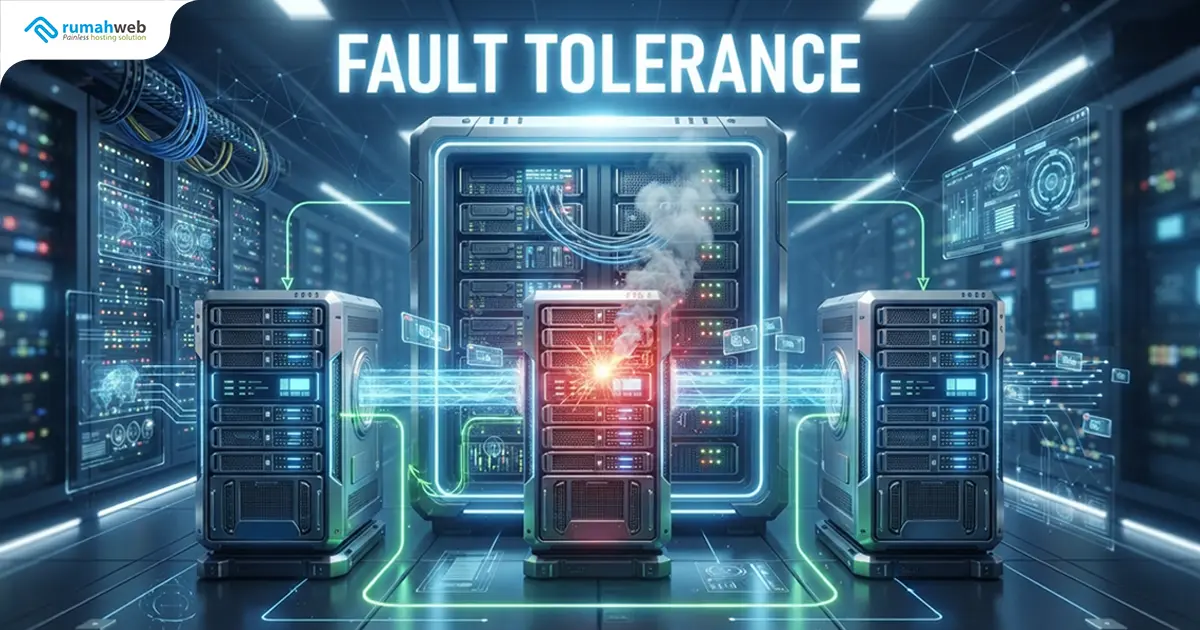
Contoh sederhananya, ketika satu server mati, layanan masih bisa berjalan karena ada server lain yang mengambil alih. Begitu juga ketika satu disk mengalami kerusakan, data tetap dapat tersedia karena memiliki salinan atau replikasi.
Apa yang Terjadi Jika Sistem Tidak Memiliki Fault Tolerance?
Tanpa fault tolerance, kegagalan satu komponen dapat mengganggu seluruh layanan, terutama jika sistem tidak memiliki redundansi atau mekanisme pengalihan otomatis (failover). Dampaknya bergantung pada arsitektur dan komponen yang mengalami kegagalan.
Beberapa risiko yang dapat terjadi antara lain:
- Downtime layanan: ketika server utama mengalami gangguan, aplikasi atau website bisa tidak dapat diakses hingga server kembali berfungsi.
- Transaksi gagal: proses pembayaran, pemesanan, atau penyimpanan data dapat terhenti ketika komponen yang memprosesnya mengalami kegagalan.
- Gangguan operasional: tim perlu melakukan pemeriksaan dan perbaikan sebelum layanan dapat digunakan kembali.
- Pemulihan lebih lama: tanpa komponen cadangan atau mekanisme failover, layanan mungkin harus menunggu hingga komponen yang rusak diperbaiki atau dipulihkan.
Sebagai contoh, sebuah website hanya berjalan pada satu server. Ketika server tersebut mengalami kerusakan, website ikut tidak dapat diakses. Jika tersedia server cadangan dengan mekanisme failover yang dirancang dengan baik, layanan berpotensi tetap berjalan meskipun server utama bermasalah.
Karena itu, fault tolerance membantu mengurangi dampak kegagalan dengan merancang sistem agar mampu menghadapi gangguan. Namun, penerapannya perlu disesuaikan dengan kebutuhan layanan, risiko, dan biaya yang dapat ditoleransi.
Bedanya Fault Tolerance, High Availability, dan Disaster Recovery
Ketiga istilah ini sering digunakan bersamaan, tetapi sebenarnya memiliki fokus yang berbeda. Secara sederhana, fault tolerance berfokus pada kemampuan sistem tetap berjalan saat terjadi kegagalan, high availability (HA) berfokus pada menjaga layanan tetap tersedia dengan downtime seminimal mungkin, sedangkan disaster recovery (DR) berfokus pada pemulihan setelah gangguan besar.
Fault Tolerance
Tujuan utamanya adalah membuat sistem tetap beroperasi meskipun ada komponen yang gagal. Karena itu, desain sistem biasanya menggunakan redundansi dan mekanisme untuk mengisolasi kegagalan.
High Availability (HA)
HA bertujuan menjaga layanan tetap tersedia dengan mengurangi downtime. Teknik yang umum digunakan antara lain:
- Load balancer.
- Health check.
- Failover otomatis.
- Redundansi antar-instance.
- Rolling update.
AWS juga merekomendasikan agar sistem dapat mengalihkan trafik ke resource yang sehat ketika terjadi kegagalan.
Disaster Recovery (DR)
DR memiliki cakupan yang lebih luas. Fokusnya adalah bagaimana layanan dan data dapat dipulihkan ketika terjadi gangguan besar, misalnya kerusakan infrastruktur atau gangguan pada lokasi utama.
Strategi DR biasanya mencakup:
- Backup data.
- Replikasi.
- Pemisahan lokasi atau region.
- Runbook pemulihan.
- Pengujian failover secara berkala.
Dengan kata lain, fault tolerance membantu sistem tetap berjalan saat komponen gagal, HA membantu menjaga layanan tetap tersedia, sedangkan DR menyiapkan proses pemulihan ketika terjadi gangguan yang lebih besar.
Metrik Penting: SLA, SLO, RTO, dan RPO
Membicarakan sistem yang andal tidak cukup hanya dengan mengatakan “uptime tinggi”. Tim perlu memiliki ukuran yang jelas agar kebutuhan reliability dapat diterjemahkan menjadi target teknis.
Beberapa istilah yang perlu dipahami adalah:
- SLA (Service Level Agreement): tingkat layanan yang dijanjikan kepada pelanggan, misalnya uptime 99,9%.
- SLO (Service Level Objective): target tingkat layanan yang ingin dicapai oleh tim.
- RTO (Recovery Time Objective): batas waktu maksimal yang ditargetkan untuk memulihkan layanan.
- RPO (Recovery Point Objective): jumlah kehilangan data yang masih dapat ditoleransi, misalnya maksimal 15 menit data.
AWS juga menyarankan agar target availability dan SLA ditentukan berdasarkan kebutuhan bisnis, bukan sekadar memilih angka uptime setinggi mungkin.
Contoh Arsitektur Fault Tolerance
Penerapan fault tolerance dapat dimulai dari arsitektur sederhana dan ditingkatkan sesuai kebutuhan bisnis.
1. Single Server
Ini merupakan arsitektur paling sederhana sekaligus paling rentan. Jika server mengalami masalah, layanan juga ikut berhenti.
Single server pada dasarnya belum fault tolerant karena masih memiliki single point of failure.
2. Dua Instance + Load Balancer
Tahap berikutnya adalah menjalankan dua instance aplikasi di belakang load balancer.
Komponennya dapat terdiri dari:
- Load balancer.
- Dua application instance.
- Health check.
- Mekanisme untuk mengganti instance yang bermasalah.
Jika salah satu instance gagal, trafik dapat dialihkan ke instance lain yang masih sehat. Pola seperti ini merupakan salah satu pendekatan untuk meningkatkan ketahanan terhadap kegagalan komponen.
3. Replikasi dan Backup pada Data Layer
Fault tolerance tidak cukup hanya diterapkan pada server aplikasi. Data juga harus diperhatikan.
Beberapa strategi yang umum digunakan antara lain:
- Replikasi database.
- Storage redundancy.
- Backup terjadwal.
- Pengujian restore secara berkala.
Tujuannya agar kerusakan pada satu komponen penyimpanan tidak langsung menyebabkan kehilangan seluruh data.
4. Multi-Zone atau Multi-Region
Jika kebutuhan reliability semakin tinggi, sistem dapat ditempatkan di lebih dari satu lokasi. Dengan begitu, kegagalan pada satu zona atau lokasi tidak otomatis menghentikan seluruh layanan.
AWS menggunakan konsep Availability Zone untuk membantu mengisolasi kegagalan dan memungkinkan workload melakukan failover ke resource yang masih sehat.
Teknik Praktis untuk Meningkatkan Fault Tolerance
Setelah mengetahui konsep dasarnya, Anda bisa mulai meningkatkan ketahanan sistem secara bertahap. Fokus utamanya adalah mengurangi single point of failure, menyediakan redundansi, dan mengotomatiskan proses pemulihan.
Beberapa teknik yang bisa diterapkan antara lain:
- Load balancing untuk membagi trafik ke beberapa instance.
- Stateless application agar instance dapat diganti tanpa kehilangan state pengguna.
- Circuit breaker untuk mencegah kegagalan satu layanan menyebar ke layanan lain.
- Retry dengan backoff untuk menangani gangguan sementara.
- Rate limiting untuk mengendalikan beban berlebih.
- Health check untuk mendeteksi instance yang bermasalah.
- Graceful degradation dengan menonaktifkan fitur non-kritis ketika sistem sedang mengalami gangguan.
Checklist Implementasi Fault Tolerance
Untuk tim kecil, tidak perlu langsung membangun arsitektur yang sangat kompleks. Mulailah dengan komponen yang paling penting bagi bisnis.
Berikut checklist yang bisa digunakan:
- Tentukan target SLA dan SLO.
- Petakan komponen kritis seperti aplikasi, database, storage, dan DNS.
- Identifikasi dan kurangi single point of failure.
- Pasang monitoring dan alert untuk latency, error rate, serta resource usage.
- Buat backup secara berkala.
- Lakukan uji restore, bukan hanya membuat backup.
- Siapkan runbook untuk incident dan disaster recovery.
- Lakukan simulasi kegagalan secara berkala di environment yang aman.
AWS juga menekankan pentingnya monitoring, automation, serta pengujian resiliency untuk membantu sistem menghadapi kegagalan dan mempercepat proses pemulihan.
Kebutuhan Bisnis Menentukan Tingkat Fault Tolerance
Tidak semua website atau aplikasi membutuhkan arsitektur multi-region. Semakin tinggi kebutuhan availability, biasanya semakin kompleks pula infrastruktur dan biaya yang diperlukan.
Sebagai gambaran:
| Kebutuhan | Pendekatan Minimum | Pengembangan Berikutnya |
|---|---|---|
| Website profil | Backup + monitoring | 2 instance + load balancer |
| Aplikasi transaksi | HA + replikasi | Multi-zone |
| Sistem kritis 24/7 | Fault tolerance + DR | Multi-region + latihan DR |
Jadi, jangan memulai dari pertanyaan “Bagaimana membuat uptime 99,999%?”. Lebih baik mulai dari pertanyaan “Berapa lama layanan boleh berhenti dan berapa banyak data yang boleh hilang?” Jawaban tersebut akan membantu menentukan arsitektur yang sesuai dengan kebutuhan bisnis.
Fault Tolerance Dimulai dari Fondasi Server yang Fleksibel
Penerapan reliability tidak selalu harus dimulai dengan infrastruktur yang kompleks. Untuk banyak tim, langkah awalnya bisa berupa memisahkan aplikasi dan database, menambahkan instance untuk redundansi, menjadwalkan backup, serta memasang monitoring.
Untuk kebutuhan tersebut, VPS Murah dari Rumahweb dapat menjadi salah satu pilihan infrastruktur. VPS Rumahweb menggunakan KVM dengan resource terisolasi, SSD storage, DDoS protection, serta dua availability zone. Layanan ini juga menawarkan aktivasi instan, SLA uptime 99,9%, sertifikasi ISO 27001, dan dukungan 24/7, dengan paket mulai Rp50.000/bulan.
Dengan fondasi server yang fleksibel, pengembangan arsitektur dapat dilakukan secara bertahap sesuai pertumbuhan aplikasi dan kebutuhan reliability.
FAQ
Berikut beberapa pertanyaan tentang apa itu Fault tolerance.
Fault tolerance adalah kemampuan sistem untuk terus berjalan ketika satu atau lebih komponen gagal.
Fault tolerance menekankan sistem tetap berjalan saat ada kegagalan komponen, sedangkan high availability menekankan uptime tinggi melalui redundansi dan failover cepat.
HA fokus mencegah downtime dan mempercepat failover saat gangguan lokal, sedangkan DR fokus pemulihan setelah kejadian besar dengan target RTO/RPO.
Minimal perlu backup, monitoring, dan rencana pemulihan. Level fault tolerance yang lebih tinggi dibutuhkan jika downtime berdampak besar pada penjualan atau layanan.
Tidak. Fault tolerance bertujuan menjaga sistem tetap beroperasi saat terjadi kegagalan komponen, tetapi tidak menjamin sistem bebas downtime. Karena itu, penerapannya perlu didukung pemantauan, pengujian, dan mekanisme pemulihan yang sesuai.
Kesimpulan
Fault tolerance (toleransi kesalahan) adalah kemampuan suatu sistem untuk tetap beroperasi secara normal meskipun terjadi kegagalan pada salah satu komponennya. Konsep ini berbeda dari High Availability (HA) dan Disaster Recovery (DR), tetapi ketiganya saling melengkapi untuk menjaga keandalan sistem secara menyeluruh.
Langkah penerapannya sebaiknya dimulai dengan memetakan metrik dan kebutuhan bisnis, mengeliminasi titik kegagalan tunggal (single point of failure), mengotomatiskan proses dialihkelimpahan (failover), memperkuat lapisan data (data layer), serta rutin melatih alur pemulihan (recovery). Jika dilakukan secara bertahap, keandalan sistem (reliability) akan meningkat signifikan tanpa memicu lonjakan biaya secara mendadak.